Оптимизация сайта под нейросети: как попасть в ответы Алисы и ChatGPT
Как нейросетевой поиск выбирает источники и что менять на сайте, чтобы попасть в ответы Алисы, ChatGPT и Google: доступ ботов, robots.txt, структура, llms.txt, замеры, расчёт и план на 90 дней.
Содержание статьи
- 01Как нейросетевой поиск выбирает источники: от вопроса до ссылки в ответе
- 02Чем оптимизация под нейросети отличается от привычного SEO
- 03Технический фундамент: индексация, доступ ботов, сниппеты и скорость
- 04Правила для ИИ-ботов в robots.txt: кого пускать, кого закрывать и как не потерять поиск
- 05Контент, который цитируют: ответ в первых строках и один смысл на блок
- 06Какие вопросы задают нейропоиску: веер подзапросов и карта покрытия
- 07Структура страницы и разметка: заголовки, списки, таблицы, Schema.org
- 08Файл llms.txt: что в него пишут, что говорят поисковики и стоит ли тратить на него день
- 09Авторитетность и упоминания: почему нейросеть ссылается на одних и обходит других
- 10Как понять, что сайт попал в ответы: Вебмастер, Search Console, аналитика и ручной замер
- 11Стоит ли браться: расчёт окупаемости на условном примере
- 12План работ на 90 дней: от первого замера до повторного
- 13Чек-лист из 16 пунктов: что проверить на сайте до начала работ
- 14Где ломается попадание в ответы: шесть ошибок в настройке и подходе
- 15Своими силами или с подрядчиком: где проходит граница и как выбрать исполнителя
- 16Частые вопросы
Вы вводите в Яндекс вопрос про свою услугу, и над обычной выдачей появляется ответ Алисы: несколько абзацев текста и ссылки на сайты-источники. Вашего сайта среди них нет, а у конкурента есть. Эта статья объясняет, как нейросетевой поиск выбирает такие источники, что из этого вы можете изменить на своём сайте и как проверить, что изменения сработали.
Текст написан для владельца бизнеса и маркетолога, которому нужно решить, вкладываться ли в это направление и с чего начинать. Мы опираемся на справочные страницы Яндекса, Google, OpenAI, Anthropic и Perplexity, а не на пересказы «гуру». Где площадка ничего не гарантирует, так и пишем. Дальше: как устроен выбор источников, настройка доступа для ИИ-ботов, структура контента, файл llms.txt, замеры, расчёт окупаемости, план на 90 дней и чек-лист.
Как нейросетевой поиск выбирает источники: от вопроса до ссылки в ответе
Нейросеть в поиске не вспоминает ответ из памяти, как чат без интернета. Она разбирает вопрос и при необходимости делит его на подзапросы, достаёт из индекса страницы-кандидаты, составляет из фрагментов связный ответ и показывает ссылки на источники.
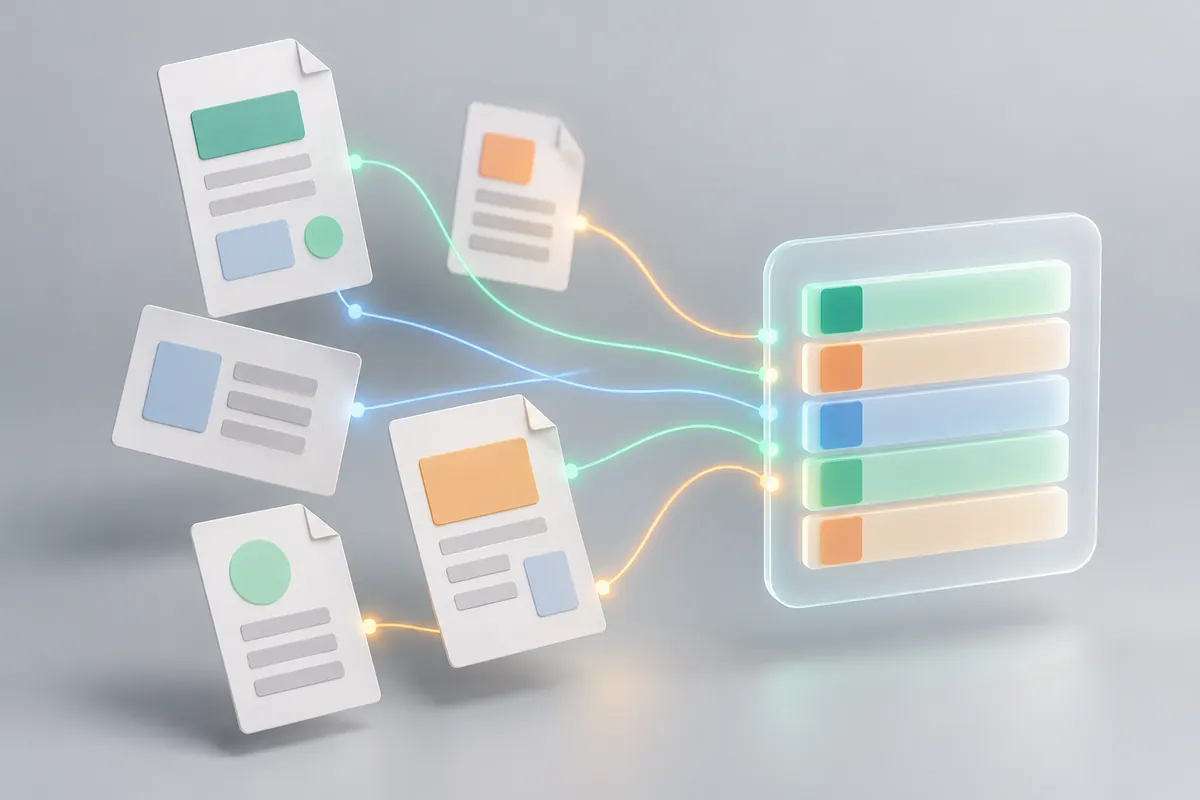
В профессиональной среде эту схему называют RAG, устройство разобрано в отдельном термине. Нам важен практический вывод: ссылку получает страница, которую система сначала нашла, а потом сочла подходящей для этой части ответа. Не нашла, значит, не процитирует.
Что пишут сами площадки
- Яндекс, Поиск с Алисой (Алиса AI). Источники — страницы с качественным контентом, где важнее всего экспертность, полезность, оригинальность и содержательность. Ответы дополняют выдачу, а не заменяют её.
- Яндекс, запуск «Нейро» (16 апреля 2024 года). Факты берутся не из памяти модели, а из источников в интернете; учитываются высокая позиция сайта в Поиске и контент, полезный для ответа. Сегодня такие ответы работают как Поиск с Алисой.
- Яндекс, быстрые ответы. Строятся из проиндексированных страниц, часть генерирует YandexGPT, и только для России. Шанс повышают структурированная информация и грамотное изложение.
- Google, «Обзоры от ИИ» и «Режим ИИ». Руководство описывает поиск актуальных страниц в индексе и query fan-out: модель сама формулирует набор связанных запросов. Вывод Google: базовые принципы SEO продолжают работать.
Три условия и отсутствие гарантий
Из этого складывается рабочая модель. Страница доступна роботу и есть в индексе. Она отвечает на вопрос полнее и яснее соседних кандидатов. На неё безопасно сослаться: понятно, кто автор и компания, факты проверяемы, данные не устарели.
Гарантий нет. Google пишет, что индексирование и показ не гарантированы даже страницам, выполнившим все требования. По справке Яндекса, ответ на тот же запрос меняется со временем и зависит от персонализации, а ссылки на источники Алиса AI не ранжирует. Поэтому «первое место в нейросети» — обещание без реальной позиции.
Чем оптимизация под нейросети отличается от привычного SEO
Часть рынка продаёт «GEO» и «AEO» как отдельную дисциплину с секретами. Google в руководстве для генеративного ИИ с этим не согласен: это по-прежнему SEO, потому что ИИ-функции опираются на основные системы ранжирования. Мы согласны наполовину. Фундамент общий, но результат выглядит и измеряется иначе.
| Параметр | Классическое SEO | Ответы нейросетей |
|---|---|---|
| Единица успеха | Позиция страницы в списке | Упоминание сайта и ссылка внутри ответа |
| Порядок источников | Задаёт ранжирование | В Алисе AI ссылки не ранжируются, а расположены по логике ответа |
| Стабильность | Позицию можно снять в конкретный день | Ответ на тот же запрос меняется и зависит от персонализации |
| Метрика | Позиции, показы, клики | Доля ответов с упоминанием, показы в ИИ-функциях |
Общее остаётся: если страница не проиндексирована, медленно открывается или дублирует соседние, нейросеть её не выберет по тем же причинам, что и обычная выдача. Яндекс при запуске «Нейро» сам назвал высокую позицию в Поиске одним из двух факторов отбора. Если базовое продвижение не сделано, начните с него: шаги описаны в материале о том, как вывести сайт в ТОП Яндекса.
Меняются две вещи. Конкуренция идёт не за строчку, а за то, чтобы ваш абзац оказался тем, из которого взяли факт. А пользователь получает ответ и может не перейти на сайт, поэтому странице нужна причина для клика: деталь, цена, расчёт, действие.
Технический фундамент: индексация, доступ ботов, сниппеты и скорость
Самая обидная потеря — когда контент хороший, а робот до него не добирается. Четыре проверки стоит сделать первыми.
- Страница отдаёт код 200 и есть в индексе. Google требует, чтобы страница была в индексе и могла показываться со сниппетом. Проверка: Яндекс Вебмастер и Search Console.
- Роботов не режут ни robots.txt, ни защита. Google советует разрешить сканирование в robots.txt и в настройках CDN и хостинга. Антибот-фильтры иногда отдают роботам 403 или капчу. Найдите в логах сервера YandexBot, Googlebot и OAI-SearchBot: у них должен быть код 200.
- Нет случайных запретов показа. Директивы nosnippet, data-nosnippet, max-snippet и noindex ограничивают то, что поисковик показывает из ваших страниц. Старая настройка вроде
max-snippet:0может тихо выводить страницу из ИИ-ответов. - Ключевой текст лежит в HTML, который отдаёт сервер. Google допускает JavaScript, если он не заблокирован, но наш совет проще: тексты, таблицы и вопросы-ответы должны быть в исходном коде, а не появляться после работы скриптов. Если сайт рисует контент в браузере, это задача для разработки сайта: нужна серверная отрисовка ключевых страниц.
Добавьте скорость, удобство на телефоне и сокращение дублей контента: Google называет эти пункты частью технической базы для ИИ-функций.
Проверка доступа бота за час
- Откройте robots.txt и найдите правила для нужных ботов; для Яндекса есть «Анализ robots.txt» в Вебмастере.
- Пусть разработчик запросит важные страницы с User-Agent бота и сравнит ответ с ответом для браузера: код и размер должны совпасть.
- Найдите в логах за неделю визиты OAI-SearchBot, PerplexityBot, Claude-SearchBot, YandexBot, Googlebot. Нулевые визиты при открытом robots.txt — признак того, что бота останавливает защита.
- Если файрвол жёсткий, добавьте в разрешённые адреса, которые публикуют OpenAI и Perplexity.
Правила для ИИ-ботов в robots.txt: кого пускать, кого закрывать и как не потерять поиск
Файл robots.txt — основной рычаг управления доступом роботов. Боты для поиска и боты для обучения моделей у большинства площадок разделены, и решение по каждой группе принимается отдельно. Закрыть всех одной строкой значит заодно выпасть из ответов.
| Токен | Чей и для чего | Если закрыть |
|---|---|---|
| YandexAdditional, YandexAdditionalBot | Яндекс: источники для быстрых ответов на базе YandexGPT и для Поиска с Алисой | Сайт уйдёт из таких ответов; бот сам страницы не индексирует, а ограничивает показ уже проиндексированных; изменения учитываются в течение 2-14 дней |
| Google-Extended | Google: токен, которым управляют использованием контента для обучения моделей Gemini и для заземления (grounding) в Gemini Apps и Vertex AI | На включение в Поиск и ранжирование не влияет, это указано в справке Google |
| OAI-SearchBot | OpenAI: поиск в ChatGPT | Сайт исключат из ответов ChatGPT search; страница может остаться как «навигационная ссылка»; около 24 часов |
| GPTBot | OpenAI: данные для обучения моделей | Контент не будут использовать для обучения; поиск не затронут |
| Claude-SearchBot, ClaudeBot | Anthropic: первый улучшает поиск, второй собирает данные для обучения | Закрыв Claude-SearchBot, вы снизите видимость в результатах; ClaudeBot исключит контент из обучения |
| PerplexityBot | Perplexity: ссылки в результатах; для обучения базовых моделей не используется | Сайт может не появиться в результатах Perplexity |
Боты, которые приходят по просьбе пользователя (ChatGPT-User, Claude-User, Perplexity-User), работают под конкретный вопрос, и OpenAI с Perplexity пишут, что правила robots.txt к ним могут не применяться. Googlebot закрывать нельзя: сайт выпадет из Google целиком.
Две стратегии для сайта компании
Открыто для всех. Подходит большинству сайтов услуг и товаров. Убедитесь, что нигде не остался Disallow: /.
В ответы можно, в обучение нельзя. Закрываются боты обучения, боты поиска остаются:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
Оговорка про Яндекс: в справке описан запрет для YandexAdditional и YandexAdditionalBot, а настройки «в ответы можно, на обучение нельзя» в справке не описано. Закрыв эти токены, вы уберёте сайт из Поиска с Алисой, и для коммерческого сайта мы такой запрет не советуем.
Robots.txt управляет обходом, а не показом: по словам OpenAI, сайт, закрытый для OAI-SearchBot, всё равно может появиться как «навигационная ссылка». Чтобы убрать страницу из результатов поиска, Google советует закрывать её директивой noindex, а не robots.txt. Проверяйте файл после каждого релиза и смены хостинга: на рабочем сайте бывает, что остаётся запрет User-agent: * с Disallow: /, перенесённый с тестового сервера.
Контент, который цитируют: ответ в первых строках и один смысл на блок
Нейросети собирают ответ из фрагментов. Если нужный лежит на шестом экране под историей компании, система возьмёт тот, что нашла быстрее. Главное правило: ответ идёт в начале раздела, доказательства и детали после него. Формула блока: заголовок словами клиента, прямой ответ в двух-трёх предложениях (ориентир 40-80 слов — наша рекомендация, а не требование площадок), затем список, таблица или расчёт, затем ограничения и следующий шаг.
Пример: как переписать начало страницы
Допустим, компания ставит натяжные потолки, а клиент спрашивает: «сколько стоит потолок на 20 квадратных метров». Цифры условные. До: три абзаца о том, что компания работает с 2010 года и использует современные материалы, цена в таблице в конце. После:
Натяжной потолок на 20 м² в нашем примере стоит от 13 000 до 22 000 ₽ при матовом полотне. Цена зависит от материала полотна, числа углов и количества светильников. Ниже таблица расчёта и три типовых комплекта.
За три секунды видны ответ, условия и место деталей. История компании переехала в блок о доверии.
Что можно цитировать без риска, а чего делать не нужно
Хорошо цитируются определения в одно-два предложения, числа с единицами и датой, таблицы сравнения, нумерованные инструкции и ограничения вроде «не подходит, если…». Ценнее всего собственные данные: замеры, расчёты, результаты проектов.
- Не нарезайте страницу на крошечные части «для ИИ». Google пишет, что делить контент так не требуется и идеальной длины страницы нет.
- Не штампуйте страницы под каждую формулировку вопроса. массовое создание слабых страниц может нарушать политику Google против спама.
- Не заменяйте экспертизу текстом без проверки. Если вы используете генеративный ИИ, факты проверяйте руками.
Как писать тексты, которые работают и в обычном поиске, разобрано в материале о том, как писать SEO-тексты. Если эксперта для страниц с цифрами и опытом нет, эту работу можно передать на создание контента, но автор должен получить от вас реальные данные.
Какие вопросы задают нейропоиску: веер подзапросов и карта покрытия
В руководстве Google вопрос о борьбе с сорняками на газоне превращается в набор запросов о гербицидах, прополке без химии и профилактике. Для бизнеса вывод простой: клиент задаёт один вопрос, а система собирает ответ из нескольких тем, и вы можете попасть в источники, отвечая на одну из них. Вопрос «как выбрать CRM для отдела продаж из десяти человек» раскладывается на сравнение функций, цены, интеграции, сроки и ошибки внедрения. У компании, которая внедряет CRM, на каждую из пяти тем должна быть страница или раздел.
Где взять вопросы: 50 последних вопросов из переписок и заявок, длинные формулировки в Вордстате, подсказки поиска и вкладка примеров запросов в Вебмастере. Уточнения к основному запросу в Вордстате показывают, как люди сужают вопрос под себя, например «оптимизация коммерческих сайтов под нейросети»: ищут ответ для своего типа сайта.
Разложите вопросы по типам и проверьте, у каждого ли есть страница с прямым ответом.
| Тип вопроса | Пример | Формат ответа |
|---|---|---|
| Выбор и сравнение | Шаблон или разработка с нуля | Таблица по критериям и вывод для каждого сценария |
| Цена | Сколько стоит интернет-магазин | Вилка с условиями: что входит, от чего зависит |
| Как сделать | Как настроить фид для маркетплейса | Нумерованные шаги и результат каждого |
| Доверие | Кому доверить поддержку сайта | Факты, кейсы, документы, имена экспертов |
Пустая клетка — точка роста. Ответы на подзапросы могут жить на разных страницах, поэтому связывайте их внутренними ссылками, чтобы и людям, и роботам было проще найти нужный раздел.
Структура страницы и разметка: заголовки, списки, таблицы, Schema.org
Яндекс называет структурированную информацию одним из факторов попадания в быстрые ответы, а в английской версии справки по Поиску с Алисой пишет, что структурированные и содержательные страницы с большей вероятностью используются для ответов. Структура — подсказка роботу и человеку, где что лежит.
- Один заголовок первого уровня и подзаголовки по предмету. «Сколько стоит монтаж» лучше, чем «Преимущества».
- Списки для перечислений, нумерация для шагов, таблицы для сравнения трёх и более объектов по двум и более признакам. Единицы и даты пишите в ячейках.
- Блок вопросов и ответов в конце страницы на реальных вопросах клиентов, без повтора основного текста.
- Видимая дата обновления и автор. Яндекс советует при падении доли упоминаний проверить, не устарел ли контент.
- Изображения и видео там, где они помогают понять, с осмысленными подписями и атрибутом alt: Google рекомендует качественные изображения и видео.
О форматах и типах микроразметки написано в глоссарии, здесь только то, что касается ИИ-ответов. Google пишет, что специальной разметки schema.org для них нет и добавлять её ради них не нужно. Но разметка остаётся частью обычного SEO и должна совпадать с видимым текстом: если в ней одна цена, а на странице другая, это расхождение, а не преимущество. Рабочий минимум: Organization, BreadcrumbList, для статей Article с автором и датой, для товаров Product и Offer, для локального бизнеса адрес и часы работы.
Файл llms.txt: что в него пишут, что говорят поисковики и стоит ли тратить на него день
llms.txt продают как волшебную кнопку для нейросетей. На деле это предложение Джереми Говарда от 3 сентября 2024 года, проект предлагает стандартизировать такой файл, но принятым стандартом он не является. В корне сайта лежит файл в формате Markdown: заголовок с названием (единственная обязательная часть), цитата с кратким описанием, разделы со списками ссылок и раздел Optional для второстепенных ссылок.
# ОкнаДом
> Производство и установка окон ПВХ для квартир и коттеджей. Замер бесплатно.

## Услуги
- [Окна ПВХ](https://example.ru/okna): профили, стеклопакеты, цены за комплект
- [Монтаж](https://example.ru/montazh): этапы работ, гарантия

## Optional
- [О компании](https://example.ru/about): реквизиты и лицензии
Что говорят поисковики и наш вердикт
- Google. В руководстве сказано, что для появления в Поиске не нужно создавать новые машиночитаемые файлы, текстовые файлы для ИИ, разметку или Markdown, потому что сам Поиск их не использует. Создавать такие файлы можно, но они ни вредят, ни помогают видимости.
- Яндекс, OpenAI, Anthropic, Perplexity. В справочных страницах о Поиске с Алисой, быстрых ответах и описаниях ботов файл как условие попадания в ответы не упоминается.
Файл дешёвый: на аккуратную подготовку хватит нескольких часов. Поэтому порядок такой: сначала доступ ботов, структура и контент. Для сайта с документацией, API или базой знаний файл имеет смысл, это тот случай, для которого его придумали. Для сайта услуг его можно добавить в конце без ожиданий отдачи, ссылки в нём должны вести на рабочие страницы. А если вам продают «внедрение llms.txt для попадания в нейросети» как основную услугу, попросите документ площадки, который это подтверждает. Мы такого не нашли.
Авторитетность и упоминания: почему нейросеть ссылается на одних и обходит других
Яндекс называет критериями экспертность, полезность, оригинальность и содержательность, Google просит собственную точку зрения и личный опыт. В SEO эти требования объединяют под аббревиатурой E-E-A-T, определение разобрано в термине. Здесь практика: из чего складывается «на эту страницу безопасно сослаться».
Внутри сайта
- Автор и эксперт: имя, должность, опыт, страница эксперта. Анонимная статья вызывает меньше доверия, чем подписанная.
- Данные о компании: юрлицо, адрес, контакты, реквизиты, лицензии, если они нужны в вашей отрасли.
- Собственные данные и кейсы с цифрами: что было, что сделано, что получилось, при каком бюджете и за какой срок. Этого нет у конкурентов.
- Актуальность: даты обновления, пересмотр цен и условий на приоритетных страницах минимум раз в квартал.
Вне сайта
Нейросети читают не только ваш сайт: Google пишет, что генеративные функции могут показывать мнения о товарах с блогов, видео и форумов. Если о вас нигде, кроме вашего сайта, не пишут, у модели мало причин считать вас авторитетом. Работайте с реальными площадками: отраслевые каталоги с проверкой компаний, независимые отзывы с подтверждением сделки, экспертные комментарии в профильных изданиях, карточка организации на Яндекс Картах с актуальными данными. Единое название и адрес на всех площадках помогают системе понять, что это один участник рынка.
Покупка «упоминаний» пакетами и одинаковые отзывы — тупик. Google пишет, что поиск искусственных упоминаний оказывается не таким полезным, как кажется, а системы против спама отсеивают накрутку.
Как понять, что сайт попал в ответы: Вебмастер, Search Console, аналитика и ручной замер
Позиции по ключам не помогут: ответ строится заново на каждый запрос. Нужны отчёты площадок, аналитика переходов и своя проверка по набору вопросов. Устройство самой веб-аналитики разобрано в глоссарии.
Яндекс: «Видимость сайта в Алисе AI»
В Яндекс Вебмастере с 7 апреля 2026 года работает инструмент «Видимость сайта в Алисе AI» в разделе «Эффективность». Он показывает диапазон упоминаний (топ-3, топ-10, топ-20), динамику Share of Voice (SoV) — доли запросов с упоминанием вашего сайта среди запросов, на которые ответила Алиса AI, — и примеры сайтов, запросов и страниц с фильтром «Запросы с моим сайтом».
Ограничения: данные за три месяца, обновление раз в неделю; учитываются только запросы, по которым сайт уже достаточно высоко в выдаче; клики и показы инструмент не считает; управлять попаданием через него нельзя. Как читать SoV, покажем на условных числах. Алиса AI ответила на 400 запросов выборки, ваш сайт упомянут в 36: 36 / 400 = 9%. Через два месяца ответов 380, упоминаний 52: 52 / 380 ≈ 13,7%. Рост на 4,7 процентного пункта можно связывать с вашей работой, если выборка в целом та же: одно значение говорит мало, важна динамика.
Google, ChatGPT и остальные
В Search Console есть отчёт об эффективности для генеративного ИИ: по справке Google, с 31 августа 2026 года он доступен всем сайтам. Он считает показы в «Обзорах от ИИ» и «Режиме ИИ» с группировкой по страницам, странам, датам и устройствам. ChatGPT обычно добавляет к ссылкам на источники параметр utm_source=chatgpt.com, по нему визиты можно выделить в аналитике; проверьте, видна ли метка в ваших данных. Для Perplexity и Claude смотрите реферальные домены и логи: визит OAI-SearchBot или Claude-SearchBot говорит лишь о том, что страницу обошли, а не процитировали.
Ручной замер: 30 вопросов раз в месяц
- Составьте 30 вопросов клиентов: 10 про услуги и товары, 10 про выбор и сравнение, 10 про цены и проблемы.
- Прогоните их в Поиске с Алисой, ChatGPT с поиском и «Режиме ИИ» Google, каждый два-три раза в разных сессиях: ответы меняются.
- Записывайте площадку, вопрос, упомянут ли ваш сайт, какая страница указана и какие конкуренты названы.
- Считайте долю вопросов с упоминанием по каждой площадке и храните историю.
Замер покажет то, чего нет в отчётах площадок: темы, где вас нет совсем, и конкурентов, которых система выбирает вместо вас.
Стоит ли браться: расчёт окупаемости на условном примере
Никто, включая нас, не знает заранее, сколько переходов принесут ИИ-ответы именно вашему сайту, поэтому считаем от обратного: сколько визитов нужно, чтобы вложение окупилось. Все цифры условные. Допустим, компания монтирует вентиляцию в коттеджах: средний чек 180 000 ₽, маржа 25%, из ста посетителей заявку оставляют двое, из ста заявок сделкой заканчиваются пятнадцать. Один визит приносит 0,02 × 0,15 × 180 000 × 25% = 135 ₽ маржи. Затраты: переписать 15 приоритетных страниц по 5 часов при цене часа 2 500 ₽ (разово), плюс 6 часов в месяц на замер и правки.
| Показатель | Расчёт | Результат |
|---|---|---|
| Разовые затраты | 15 × 5 ч × 2 500 ₽ | 187 500 ₽ |
| Ежемесячные затраты | 6 ч × 2 500 ₽ | 15 000 ₽ |
| Визитов, чтобы покрыть ежемесячные затраты | 15 000 ÷ 135 | около 111 в месяц |
| Визитов, чтобы окупить всё за 12 месяцев | (187 500 ÷ 12 + 15 000) ÷ 135 | около 227 в месяц |
Если по замеру и вопросам клиентов вы оцениваете, что ИИ-ответы и поиск по длинным вопросам могут приносить 200-300 визитов в месяц, вложение выглядит разумным. Если прогноз — десяток визитов, берите в работу только страницы, нужные и обычному SEO. Большинство работ из нашего списка (структура, ответ в начале, актуальные цены, доступ ботов) полезны и классическому поиску, так что разовые затраты не пропадут. Конкретных переходов, позиций и сроков мы не обещаем: на ответ влияют персонализация, конкуренты и алгоритмы самих площадок.
План работ на 90 дней: от первого замера до повторного
План рассчитан на сайт с несколькими десятками страниц и командой из маркетолога, разработчика и автора. Это порядок работ, а не обещание результата: сколько времени площадкам потребуется на переобход и пересборку ответов, никто не гарантирует.
| Недели | Блок | Что делаем | Готово, когда |
|---|---|---|---|
| 1-2 | Замер и доступы | Замер по 30 вопросам, Вебмастер и Search Console, проверка robots.txt, защиты и логов, выбор 10-20 страниц по выручке | Есть таблица замера и список блокеров |
| 3-4 | Техническая база | Доступ ботов, лишние запреты показа, дубли, решение по политике ботов | Боты получают 200 на приоритетных страницах |
| 3-8 | Контент | Ответ в начале, таблицы, вопросы и ответы, актуальные цены; новые страницы под пустые клетки карты покрытия | У каждого типа вопроса есть страница с ответом |
| 5-8 | Доверие | Авторы, раздел о компании с реквизитами, кейсы с цифрами, карточки на Картах, независимые отзывы | На страницах есть автор и дата, данные компании совпадают везде |
| 9-10 | Разметка и llms.txt | Сверка микроразметки с текстом; llms.txt, если он подходит вашему типу сайта | Разметка валидна, файл отдаётся по /llms.txt |
| 11-12 | Повторный замер | Те же 30 вопросов и площадки, сравнение с первым замером, решение о следующем квартале | Есть сравнительная таблица |
Роли: маркетолог или владелец отвечает за вопросы, замеры и приоритеты; разработчик — за доступ ботов, отрисовку, разметку и скорость; автор или эксперт пишет страницы (лучше, когда факты приносит специалист компании, а оформляет редактор). Дальше переходите на ритм: замер раз в месяц, обновление приоритетных страниц раз в квартал.
Чек-лист из 16 пунктов: что проверить на сайте до начала работ
Пройдите список по приоритетным страницам. Каждое «нет» в первых двух группах блокирует всё остальное, начинайте с них.
Доступ и индексация
- Страницы отдают код 200 и открыты для индексации, на них нет случайных noindex, nosnippet и max-snippet:0.
- В robots.txt нет общего запрета и правил, закрывающих YandexAdditional, OAI-SearchBot, Claude-SearchBot, PerplexityBot.
- Защита, файрвол и CDN пропускают поисковых и ИИ-роботов.
- Ключевой текст виден в исходном коде страницы, у каждой страницы один основной адрес.
Контент
- Каждый раздел начинается с прямого ответа в двух-трёх предложениях.
- Цены, сроки и условия указаны с датой актуальности.
- Для каждого типа вопроса из карты покрытия есть страница; сравнения оформлены таблицами, шаги списками.
- В тексте есть собственные данные, примеры и ограничения, а не пересказ чужих материалов.
Доверие
- Указаны автор или эксперт, его должность и опыт.
- На сайте есть реквизиты, адрес, контакты и документы, подтверждающие деятельность.
- Данные о компании одинаковы на сайте, в картах и справочниках.
- Есть независимые отзывы и упоминания вне вашего сайта.
Замер
- Сайт подключён к Яндекс Вебмастеру и Search Console.
- Есть первый замер по 30 вопросам с датой.
- В аналитике настроен сегмент для переходов из ChatGPT.
- Назначен человек, который раз в месяц повторяет замер.
Если «нет» набралось больше чем в пяти пунктах, не пытайтесь закрыть всё сразу: техническая группа, затем 10 страниц, приносящих деньги, и только потом расширение.
Где ломается попадание в ответы: шесть ошибок в настройке и подходе
Шесть ошибок, из-за которых «вроде оптимизированный» сайт не цитируется. Часть из них следует прямо из справок площадок.
- Закрыли всех ботов одной строкой. Если закрыть все ИИ-боты подряд, включая поисковые, сайт уйдёт из ответов ChatGPT, Perplexity и Claude. Закрывайте ботов обучения, а ботов поиска оставляйте.
- Ответ спрятан под вступлением. История компании в начале, цена в конце. Модель берёт фрагмент, который находит быстрее, и это не ваш.
- Ставка на llms.txt вместо контента. Файл сделали за вечер, страницы остались прежними. Google пишет, что файл ни вредит, ни помогает, а Яндекс его в справке не упоминает.
- Сотни микространиц под формулировки вопросов. Google указывает, что массовое создание таких страниц может нарушать политику против спама. Лучше одна сильная страница с несколькими разделами.
- Нет замера до и после. Без первичной таблицы непонятно, помогли ли изменения: ответ меняется и сам по себе, нужны повторные прогоны по одному списку вопросов.
- Гарантии от подрядчика. «Гарантируем ТОП в нейросетях» выполнить невозможно: ссылки в ответах не ранжируются, а ответ зависит от персонализации. Честное предложение описывает работы и показатели, а не место. Уверения, что хватит особой разметки или текстового файла, противоречат руководству Google.
Своими силами или с подрядчиком: где проходит граница и как выбрать исполнителя
Сами вы справитесь с проверкой robots.txt, подключением Вебмастера и Search Console, первым замером по 30 вопросам, переписыванием начала пяти самых денежных страниц, добавлением дат, авторов и реквизитов. Подрядчик нужен, когда сайт отрисовывает контент в браузере, боты получают 403 из-за защиты на стороне хостинга, нужно переработать десятки страниц с участием экспертов, пересобрать структуру под карту вопросов без потери позиций в обычном поиске или вести регулярный замер с отчётностью.
В BigPanda за такие работы отвечают SEO-продвижение (структура, семантика, аналитика), создание контента и разработка сайтов. Если не уверены, с чего начинать, закажите бесплатный аудит сайта: он проверит технику и SEO — robots.txt и sitemap.xml, доступность страниц, битые ссылки, скорость, мета-теги и перелинковку, — а замер по вопросам вашей ниши можно обсудить с менеджером.
Как проверить исполнителя до договора
- Попросите описать работы со ссылками на справки Яндекса и Google. «Секретные методики» вместо первоисточников — повод насторожиться.
- Спросите, как устроен замер до и после: список вопросов, площадки, число прогонов.
- Проверьте, что в договоре зафиксированы работы и показатели, а не место в ответе нейросети.
- Уточните, кто пишет тексты и откуда берутся факты и примеры.
- Потребуйте доступ к отчётам и таблицам замера: они должны храниться у вас.
Частые вопросы
Нужен ли файл llms.txt, чтобы попасть в ответы нейросетей?
Нет, как условие попадания он нигде не описан. Google пишет, что его Поиск такие файлы не использует и они ни вредят, ни помогают видимости. В справках Яндекса о Поиске с Алисой файл не упоминается. Сначала займитесь доступом ботов, структурой и содержанием страниц.
Как попасть в ответы Алисы в Яндексе?
Гарантированного способа нет. Яндекс называет источниками страницы с качественным контентом: важны экспертность, полезность, оригинальность и содержательность. На практике нужны сайт в индексе, не закрытый от YandexAdditional, прямой ответ в начале раздела, понятная структура и актуальные данные. Динамику смотрите в Вебмастере, в инструменте «Видимость сайта в Алисе AI».
Можно ли запретить нейросетям обучаться на моём сайте и остаться в ответах?
У OpenAI, Google и Anthropic можно: боты обучения (GPTBot, Google-Extended, ClaudeBot) отделены от ботов поиска, поэтому закрывают только первых. У Яндекса в справке описан запрет для YandexAdditional и YandexAdditionalBot, который убирает сайт из быстрых ответов и Поиска с Алисой, а отдельного переключателя только для обучения там нет.
Как проверить, цитирует ли нейросеть мой сайт?
В Яндексе откройте Вебмастер, раздел «Эффективность», инструмент «Видимость сайта в Алисе AI». В Google есть отчёт об эффективности для генеративного ИИ в Search Console. Для ChatGPT ищите в аналитике переходы с параметром utm_source=chatgpt.com. Дополните отчёты ручным замером: 30 вопросов клиентов, несколько прогонов по каждой площадке и таблица результатов.
Сколько времени нужно, чтобы сайт начал появляться в ответах нейросетей?
Честный срок назвать нельзя. Известны только технические интервалы: Яндекс учитывает запрет для YandexAdditional в течение 2-14 дней, OpenAI называет около суток на обновление после правки robots.txt, а Google пишет, что сканирование может занимать от нескольких дней до нескольких недель. Планируйте работы на квартал и сравнивайте результат повторным замером.